
復旧時に証跡が失われる
サービスを戻す過程で、原因調査に必要な状態や記録が残りません。
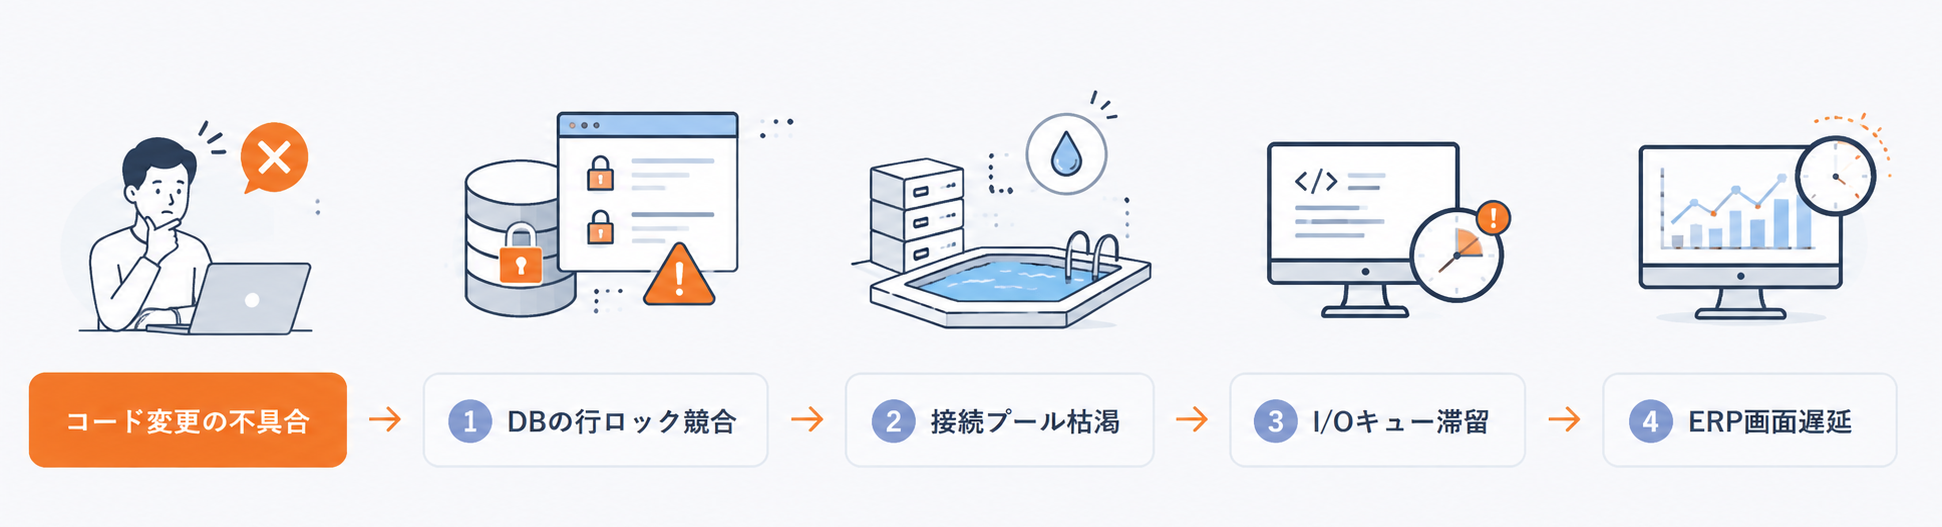
監視データ、ログ、トレース、設定変更履歴を横断し、障害の因果関係を追跡。復旧だけで終わらせず、技術的な根本原因と運用プロセス上の原因を特定し、再発防止までつなげます。
Challenges
調査が進まない背景には、データ、担当領域、時間、手順の分断があります。原因が特定されないまま復旧した障害は、同じ条件がそろえば再発します。
サービスを戻す過程で、原因調査に必要な状態や記録が残りません。
大量の通知の中に、最初に見るべき重要な事象が埋もれます。
ネットワーク、サーバー、DB、アプリが個別に判断し、全体像が見えません。
調査手順が標準化されず、特定担当者の経験と空き時間に依存します。
How It Works
経験者が頭の中で行う突き合わせを、データ、手順、ツールで再現します。
集める:ネットワーク、サーバー、DB、アプリ、クラウドのデータを集約します。
絞り込む:重複・派生アラートを整理し、調査すべき事象を残します。
因果をたどる:発生順序、依存関係、変更履歴を突合し、伝播経路を遡ります。
再発を防ぐ:恒久対策、問題管理、ナレッジ登録、解消確認までつなげます。
ManageEngine Solution Stack
ネットワーク、サーバー、ストレージの可用性と性能を監視し、発生点と影響範囲を把握します。
アプリ、ミドルウェア、DBを横断し、応答遅延やエラーを処理単位で掘り下げます。
フローデータから、帯域を利用するホスト、アプリ、通信相手、時間帯を特定します。
サーバー、Firewall、DB、クラウドなどのログを集約し、障害前後のイベントを調査します。
Web、API、クラウドの外形・可用性を監視し、利用者視点の症状を捉えます。
アラートをインシデントへ変換し、問題、変更、CMDB、ナレッジと関連付けます。
監視対象、依存関係、ログ、変更履歴を棚卸しし、収集方式を設計します。
閾値、相関ルール、誤検知、除外条件を実績に基づいて見直します。
繰り返す障害を抽出し、原因、対策、判断手順、恒久対策を管理します。
Implementation Process
監視構成、繰り返す障害、現在の調査・報告プロセスを確認します。
データ取得、構成情報、変更・対応履歴の整備状況を評価します。
対象を限定して分析フローを構築し、因果分析の有効性を確かめます。
対象を広げ、ルール、ナレッジ、問題管理プロセスを改善します。
Why Advange
ネットワーク、サーバー、クラウド、DB、アプリの因果関係を追跡します。
技術要因だけでなく、変更管理や運用プロセス上の原因まで整理します。
閾値、相関ルール、構成情報、ナレッジを継続的に更新します。
システム障害の原因分析・再発防止支援について、よくいただくご質問をまとめました。
監視データ、ログ、トレース、設定変更履歴などを横断して分析します。
はい。ネットワーク、サーバー、DB、アプリ、クラウドをまとめて調査します。
はい。対象を限定したパイロットから開始し、段階的に展開できます。
はい。変更管理や調査手順など、運用プロセス上の原因も整理します。
はい。恒久対策、問題管理、ナレッジ登録、効果確認まで支援します。
お問い合わせありがとうございます。 1喖業日内にご連絡いたします。